Kurz gesagt: Eine Erstmail im Vertrieb wird 2026 gelesen, wenn sie zeigt, dass man sich mit Person und Firma beschäftigt hat. Das Outreach Tool von hybridAI erledigt diese Recherche in knapp einer Minute: Es findet die E-Mail-Adresse, recherchiert Person und Firma mit Quellen, nennt konkrete Anknüpfungspunkte für dein Angebot und schreibt daraus die Mail. Fünf Abfragen sind kostenlos.
Jeder, der im Vertrieb arbeitet, kennt den Unterschied: Eine Mail, die mit „Sehr geehrte Damen und Herren, wir sind ein führender Anbieter…“ beginnt, wird gelöscht. Eine Mail, die zeigt, dass jemand sich mit der Person und ihrem Unternehmen beschäftigt hat, wird gelesen. Der Unterschied ist Recherche – und genau die kostet Zeit: Wer ist das, was macht die Firma gerade, wo passt mein Angebot, und wie lautet überhaupt die E-Mail-Adresse?
Das Outreach Tool von hybridAI erledigt diese Schritte zusammen.
Wen willst du erreichen – und mit was?
Eingegeben werden nur ein paar Dinge: Name und Firma der Person, optional die Domain, dein Angebot, dein Name als Absender, ein Template – Cold Outreach, Catch-up, Re-Aktivierung oder Warm Intro – und die Sprache der Mail. Im Video recherchiert das Tool Stephan Noller, Gründer von hybridAI, mit seiner Zustimmung.
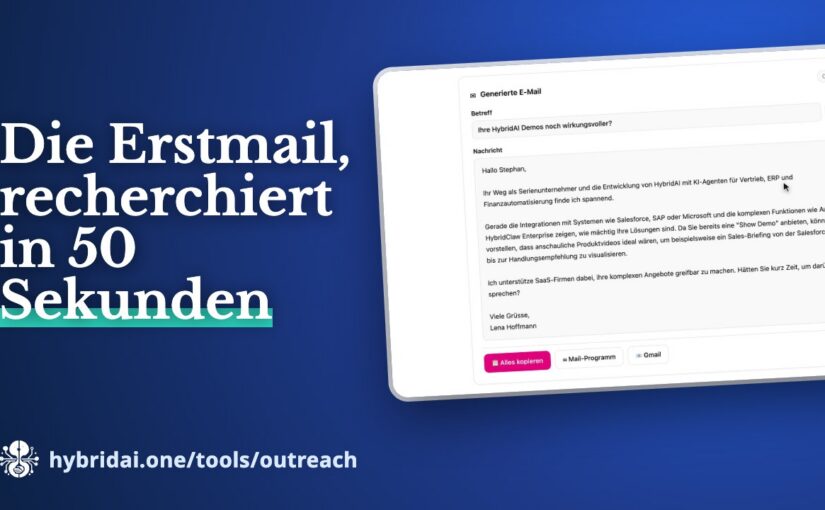
Dann laufen drei Dinge gleichzeitig: die Suche nach der E-Mail-Adresse, die Recherche zu Person und Firma und das Schreiben der Mail. In unserem Test dauerte das knapp eine Minute.
Adresse, Recherche, Anknüpfungspunkte
Zuerst die Adresse – mit einer Trefferwahrscheinlichkeit und dem LinkedIn-Profil. Darunter die Recherche: was über die Person öffentlich bekannt ist und was die Firma macht, jeweils mit Quellen. Das ist mehr als eine Visitenkarte; es ist der Stoff, aus dem ein gutes erstes Gespräch entsteht.
Der wichtigste Teil sind die Anknüpfungspunkte: konkrete Stellen, an denen das eigene Angebot zur Situation der Person passt. Genau die Arbeit, die man sonst nach zwanzig Minuten Recherche selbst im Kopf macht.
Die Mail – und was danach kommt
Aus all dem entsteht die Mail: Betreff, persönliche Anrede, ein Bezug auf das, was die Recherche ergeben hat, und ein klarer nächster Schritt. Sie lässt sich kopieren oder direkt im Mail-Programm oder in Gmail öffnen. Wie bei jedem generierten Text gilt: lesen, anpassen, dann senden.
Für die Arbeit mit mehr als einer Person gibt es das Tool auch als LLM-Skill. Das Paket bringt einem KI-Agenten bei, die Outreach-API von hybridAI zu nutzen – dann recherchiert und schreibt der eigene Agent gleich für eine ganze Liste. Wer sein Netzwerk vorher mit dem LinkedIn Netzwerk-Radar sortiert hat, hat diese Liste schon.
Häufige Fragen
Was kostet das Outreach Tool?
Fünf Abfragen sind kostenlos, ohne Anmeldung: hybridai.one/tools/outreach.
Welche Arten von Mails schreibt es?
Vier Templates: Cold Outreach, Catch-up, Re-Aktivierung und Warm Intro – in der Sprache, die du wählst.
Kann ich das für eine ganze Liste nutzen?
Ja, als LLM-Skill: Er bringt deinem KI-Agenten die Outreach-API von hybridAI bei, dann recherchiert und schreibt der Agent für alle Kontakte einer Liste.
Kann ich die Mail ungeprüft verschicken?
Nein. Wie bei jedem generierten Text: lesen, anpassen, dann senden.
Kurz gesagt: Die beste Lead-Liste ist oft das eigene LinkedIn-Netzwerk – nur zeigt LinkedIn nicht, wer davon zu deinem Angebot passt. Das LinkedIn Netzwerk-Radar von hybridAI liest den LinkedIn-Datenexport komplett im Browser aus, bewertet jeden Kontakt für dein Angebot (Relevanz 1 bis 10), sortiert dein Netzwerk in Outreach-Segmente und schreibt die erste Nachricht. Es ist kostenlos, die Kontaktdaten verlassen deinen Browser nicht.
Segment
Wer drin ist
Was du damit machst
Hot Leads
hoch bewertet und schon im Austausch
jetzt nachfassen
Decision Makers
C-Level und VP-Ebene mit hoher Relevanz
gezielt ansprechen
Schlafende Kontakte
relevant, aber noch nie angeschrieben
Re-Aktivierung
Warm Intros
Kontakte mit Empfehlung oder Endorsement
um eine Vorstellung bitten
Die meisten von uns haben ein paar hundert, oft ein paar tausend LinkedIn-Kontakte. Darunter sind ehemalige Kollegen, Kunden von früher, Menschen, die man auf einer Konferenz kennengelernt hat – und erstaunlich viele, die heute genau dort Entscheidungen treffen, wo das eigene Angebot hinpasst. Das Problem ist nicht, dass diese Kontakte fehlen. Das Problem ist, dass man sie nicht sieht.
LinkedIn selbst hilft dabei wenig. Die Kontaktliste lässt sich durchscrollen, aber nicht danach sortieren, wer für ein bestimmtes Angebot relevant ist, mit wem man schon geschrieben hat oder wer sich seit zwei Jahren nicht mehr gemeldet hat. Genau dafür haben wir das LinkedIn Netzwerk-Radar gebaut.
Der Export als Ausgangspunkt
LinkedIn erlaubt es jedem, eine Kopie der eigenen Daten herunterzuladen (Einstellungen → Datenschutz → „Kopie Ihrer Daten anfordern“). Diese ZIP-Datei zieht man ins Radar. Die Auswertung läuft komplett im Browser – die Kontaktdaten werden dafür nicht auf einen Server geladen. Wer erst einmal schauen will, kann mit den Demo-Daten des Tools starten, ganz ohne eigenen Export und ohne Anmeldung.
Bevor das Dashboard entsteht, sagt man dem Radar, worum es geht: was man anbietet, welche Branchen und welche Positionen man erreichen will. Daran richtet sich alles Weitere aus – die Bewertung jedes Kontakts genauso wie die Texte.
Vom Netzwerk zu Segmenten
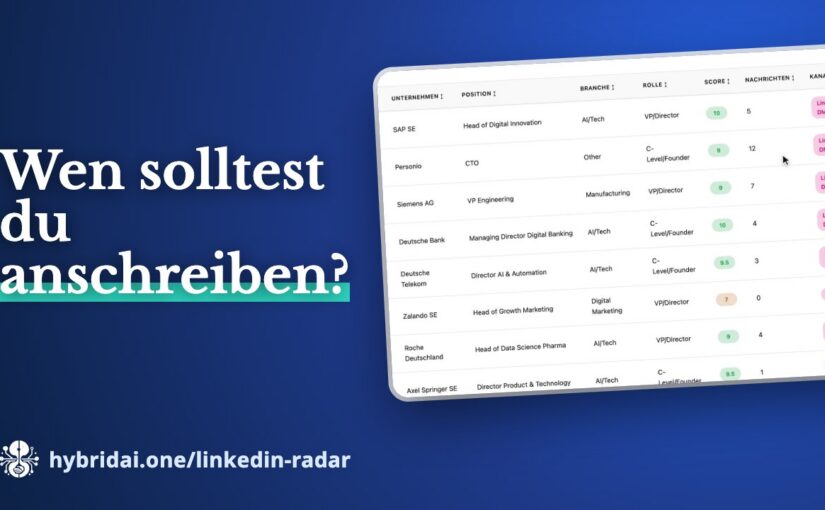
Das Dashboard zeigt zuerst die Lage: wie viele Kontakte es gibt, mit wie vielen schon Nachrichten ausgetauscht wurden und wie viele zu den High-Value Targets zählen. Darunter verteilt sich das Netzwerk nach Branchen und Positionen.
Spannender sind die Outreach-Segmente. Das Radar sortiert die Kontakte in Gruppen, mit denen man direkt arbeiten kann:
Hot Leads – hoch bewertet und schon im Austausch,
Decision Makers – C-Level und VP-Ebene mit hoher Relevanz,
Schlafende Kontakte – relevant, aber noch nie angeschrieben,
Warm Intros – Kontakte mit Empfehlung oder Endorsement.
Ein Klick auf ein Segment filtert die Kontaktliste. Jeder Kontakt hat einen Relevanz-Score von 1 bis 10, eine Einschätzung der Beziehungsstärke und den passenden Kanal.
Die erste Nachricht ist schon geschrieben
Der Teil, der im Alltag die meiste Zeit spart: Klickt man einen Kontakt an, liegt die Nachricht schon bereit – mit dem passenden Template, persönlich angesprochen, auf Deutsch oder Englisch. Es gibt Vorlagen für Re-Aktivierung, Kalt-Intro, Follow-up und Warm-Intro; einmal angepasst, gelten sie für alle Kontakte. Die Nachricht lässt sich kopieren oder direkt im Mail-Programm öffnen.
Kontakte sammelt man in eigenen Listen, etwa „Entscheider Q4“, und exportiert sie als CSV oder als E-Mail-Liste.
Das Netzwerk als Skill für deinen KI-Assistenten
Ein Knopf, der leicht zu übersehen ist, aber vielleicht der wichtigste: LLM Skill erstellen. Er packt das ausgewertete Netzwerk in ein ZIP – mit einer SKILL.md, den angereicherten Kontakten, einem Such-Skript und einer Tool-Definition. Damit kennt ein KI-Assistent das eigene LinkedIn-Netzwerk und kann Fragen beantworten wie „Welche C-Level-Kontakte habe ich in der Finanzbranche?“.
So lässt sich das Netzwerk – wenn man will – auch in unsere eigenen Assistenten einbinden: in HybridClaw, in Hy oder in den Sales Companion. Wer die Kontakte dort hat, kann den Assistenten vor einem Termin fragen, wen man bei einem Unternehmen kennt, oder sich eine Liste für die nächste Kampagne zusammenstellen lassen.
Für schnelle Fragen gibt es im Radar außerdem den Netzwerk-Assistenten: „Welche Decision Makers habe ich bei Banken?“ – und die Antwort kommt aus den eigenen Kontakten.
Häufige Fragen
Werden meine LinkedIn-Kontakte hochgeladen?
Nein. Die Auswertung läuft komplett im Browser; die Kontaktdaten werden nicht auf einen Server geladen.
Wie komme ich an meinen LinkedIn-Export?
In LinkedIn unter Einstellungen → Datenschutz → „Kopie Ihrer Daten anfordern“. Die ZIP-Datei ziehst du ins Radar. Zum Ausprobieren gibt es Demo-Daten, ohne Export und ohne Anmeldung.
Was kostet das Radar?
Nichts – es ist ein kostenloses Tool von hybridAI.
Kann mein KI-Assistent mit dem Netzwerk arbeiten?
Ja. „LLM Skill erstellen“ packt das ausgewertete Netzwerk in ein ZIP mit SKILL.md, Kontakten, Such-Skript und Tool-Definition – für HybridClaw, Hy, den Sales Companion oder andere Assistenten.
Ausprobieren
Das LinkedIn Netzwerk-Radar ist Teil des HybridAI Enterprise Assistant und lässt sich mit Demo-Daten direkt im Browser testen: hybridai.one/linkedin-radar.
Kurz gesagt: ChatGPT, Claude und Gemini schicken vor ihrer Antwort eigene Websuchen ab – und die unterscheiden sich oft von dem, was das Modell auf Nachfrage angibt. Für diese echten Suchen musst du 2026 gefunden werden. Der GEO Sniffer von hybridAI zeigt beides nebeneinander, dazu die Websites, auf die sich die Antwort stützt, die empfohlenen Marken und eine GEO-Strategie. Bis zu 15 Anfragen am Tag sind kostenlos.
Was der GEO Sniffer zeigt
Was es ist
Wofür du es brauchst
Asked
wonach das Modell nach eigener Aussage suchen würde
zeigt, wie das Modell die Frage versteht
Live
die Websuchen, die es tatsächlich abschickt
die Suchbegriffe, für die du gefunden werden musst
Was eine Seite zitierfähig macht, hat eine Auswertung von 193.507 KI-Antworten aus ChatGPT, Google AI Mode und AI Overviews (August–Oktober 2026) untersucht (AI Citation Study). Gemessen wurden Zusammenhänge, keine Ursachen:
Merkmal
Zitier-Chance
Jahreszahl im Titel
mehr als doppelt so hohe Chance
In den letzten 12 Monaten aktualisiert
+88 %
Tabellen
+69 % (in ChatGPT +88 %)
Erfahrung aus erster Hand
+45 %
Preise auf der Seite
+28 %
FAQ-Abschnitt
+26 %
Direkte Antwort am Anfang
20 % der zitierten vs. 5 % der übergangenen Seiten
Wer früher ein Werkzeug, einen Dienstleister oder eine Software gesucht hat, hat gegoogelt. Heute fragen immer mehr Menschen stattdessen ChatGPT, Claude oder Gemini – und bekommen keine Liste mit zehn Links, sondern eine Antwort mit drei, vier Empfehlungen. Wer da nicht genannt wird, existiert für diese Frage nicht.
Für Unternehmen ist das eine neue Lage. Bei Google wusste man ungefähr, wie es funktioniert: Suchbegriffe, Rankings, Backlinks. Bei KI-Assistenten ist es undurchsichtiger. Sie suchen zwar oft selbst im Web, bevor sie antworten – aber wonach genau, und auf welche Seiten sie sich am Ende stützen, sieht man nicht. Generative Engine Optimization, kurz GEO, beginnt deshalb mit einer einfachen Frage: Was passiert eigentlich zwischen der Frage und der Antwort?
Eine Frage, wie deine Kunden sie stellen
Der GEO Sniffer setzt genau dort an. Man wählt ein Modell – ChatGPT, Claude oder Gemini – und stellt eine Frage so, wie die eigenen Kunden sie stellen würden. In unserem Video ist das: „Welche CRM-Software eignet sich für kleine Agenturen?“
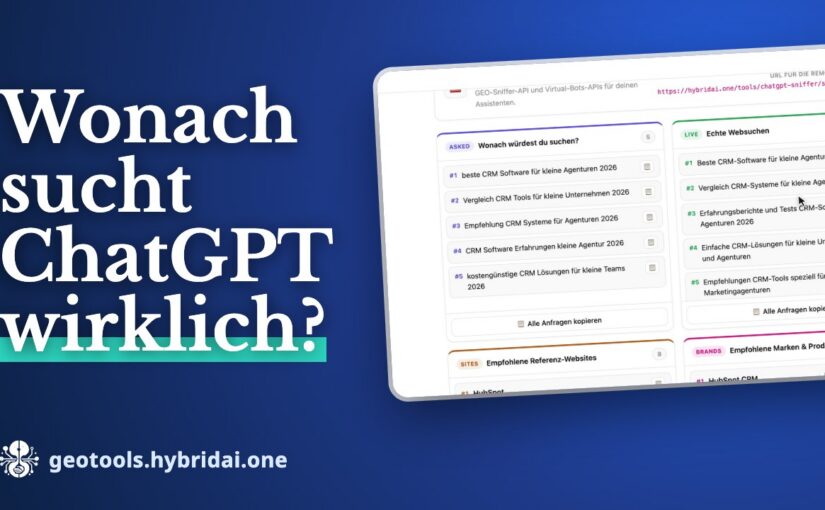
Das Ergebnis kommt in zwei Spalten, und der Unterschied zwischen ihnen ist das eigentlich Interessante:
Asked – wonach das Modell nach eigener Aussage suchen würde,
Live – die Websuchen, die es tatsächlich abschickt.
Beide Listen ähneln sich oft, sind aber selten gleich. Und es sind die echten Suchanfragen, für die man gefunden werden muss.
Wen die KI empfiehlt – und worauf sie sich stützt
Darunter stehen die Websites, auf die sich das Modell bei seiner Antwort stützt, und die Marken und Produkte, die es empfiehlt. In unserem Beispiel waren das Vergleichs- und Bewertungsportale auf der einen Seite und die bekannten CRM-Anbieter auf der anderen. Die Ergebnisse sind live und fallen bei jeder Anfrage etwas anders aus – genau wie die Antworten, die echte Nutzer bekommen.
Daraus folgt eine sehr konkrete Erkenntnis: Diese Quellen sind die Orte, an denen man präsent sein muss, wenn die KI einen nennen soll.
Von der Analyse zur GEO-Strategie
Bei der Analyse bleibt es nicht. Aus den Suchanfragen, Quellen und Marken erstellt der GEO Sniffer eine GEO-Strategie: die Keywords, um die es geht, die Plattformen, auf denen man am einfachsten gelistet wird, Ideen für Inhalte, die noch fehlen, und konkrete Schritte für die nächste Woche.
Und weil jedes Modell anders sucht, lohnt sich der Vergleich: Dieselbe Frage an Claude oder Gemini liefert oft andere Suchanfragen – und andere Empfehlungen.
Im eigenen Werkzeugkasten
Alle Suchanfragen, Websites und Marken lassen sich mit einem Klick kopieren. Wer den Sniffer regelmäßig nutzen will, lädt ihn als LLM-Skill herunter – ein ZIP mit SKILL.md und den nötigen Ressourcen für den eigenen KI-Assistenten – oder bindet ihn über die REST-API in eigene Workflows ein.
Häufige Fragen
Welche Modelle kann der GEO Sniffer abfragen?
ChatGPT, Claude und Gemini. Dieselbe Frage an verschiedene Modelle liefert oft andere Suchanfragen und andere Empfehlungen.
Was kostet der GEO Sniffer?
Bis zu 15 Anfragen am Tag sind kostenlos: geotools.hybridai.one.
Warum unterscheiden sich „Asked“ und „Live“?
Was ein Modell über seine Suche sagt, ist nicht dasselbe wie die Suchen, die es wirklich abschickt. Für GEO zählen die echten.
Kann ich ihn in eigene Workflows einbinden?
Ja, als LLM-Skill für den eigenen KI-Assistenten oder über die REST-API.
Kurz gesagt: Ein KI-Agent, der selbst E-Mails verschickt oder Daten ändert, braucht mehr als Logs: Man muss jeden Ablauf (Turn) nachvollziehen und prüfen können, dass die Aufzeichnung vollständig ist. Die Agent-Observability der hybridAI-Plattform zeichnet jeden Turn mit allen Werkzeug- und Modellaufrufen auf, sichert die Ereignisse mit Sequenznummer und Hash-Kette gegen Lücken und Manipulation und meldet Auffälligkeiten per Alarm. Sie ist für gehostete HybridClaw-Agenten verfügbar.
Klassisches Logging
Agent-Observability
Was protokolliert wird
einzelne Ereignisse mit Zeitstempel
der ganze Turn: Modell, Werkzeuge, Argumente, Ergebnisse, Reihenfolge
Fehlende Daten
fallen nicht auf
werden als Lücke angezeigt, nicht rekonstruiert
Vollständigkeit
nicht prüfbar
Sequenznummer und Hash-Kette, Status „broken“ mit Begründung
Ein Chatbot, der eine falsche Antwort gibt, ist ein Ärgernis. Ein Agent, der eigenständig eine E-Mail verschickt, einen Datensatz ändert oder ein Angebot erstellt, ist etwas anderes. Er handelt — und wer handelt, muss sich erklären können.
Die meisten Teams, die heute Agenten in Betrieb nehmen, merken das erst beim ersten Zwischenfall. Dann steht die Frage im Raum: Was genau ist da passiert? Und die ehrliche Antwort lautet überraschend oft: Wir wissen es nicht mehr.
Warum Logs für Agenten nicht reichen
Klassisches Logging ist für Software gemacht, die Anweisungen abarbeitet. Eine Zeile pro Ereignis, Zeitstempel, Schweregrad. Für einen Webserver ist das angemessen.
Ein Agent arbeitet anders. Auf eine Eingabe hin entscheidet er selbst, welche Werkzeuge er benutzt, ruft eins davon auf, bewertet das Ergebnis, ruft womöglich das nächste auf und formuliert am Ende eine Antwort. Diese Abfolge nennen wir einen Turn. Was dabei zählt, ist nicht das einzelne Ereignis, sondern der Zusammenhang: Welches Modell war beteiligt? Welche Werkzeuge wurden mit welchen Argumenten aufgerufen? Was kam zurück? Und an welcher Stelle wurde die Entscheidung getroffen, die am Ende zum Problem wurde?
Ein Chatverlauf zeigt davon nur die Oberfläche: Frage rein, Antwort raus. Alles dazwischen — und genau dort passiert das Handeln — bleibt unsichtbar.
Turn-Tracing: der Ablauf als Einheit
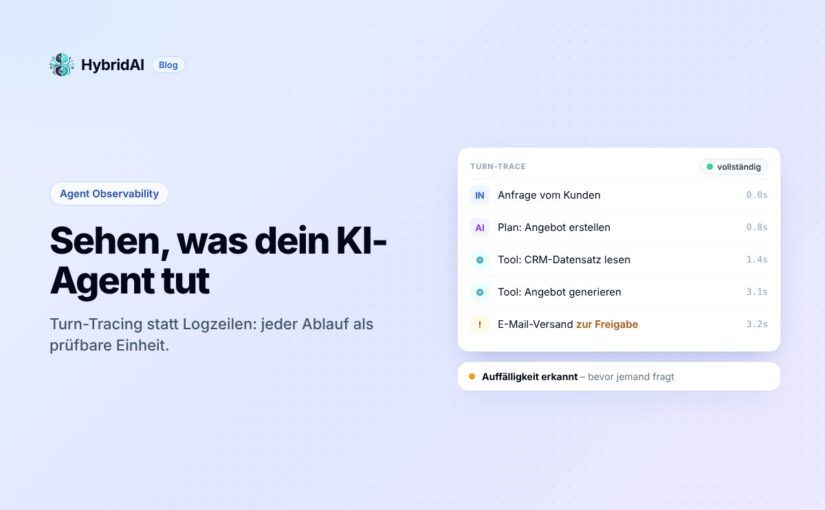
Wir haben Observability deshalb um den Turn herum gebaut und nicht um die einzelne Logzeile. Ein aufgezeichneter Turn lässt sich aufklappen wie ein Protokoll: jeder Werkzeugaufruf mit seinen Argumenten, jedes Ergebnis, jeder Modellaufruf, in der Reihenfolge, in der es tatsächlich geschah.
Das macht einen praktischen Unterschied. Bei der Frage „Warum hat der Agent diesen Kunden angeschrieben?“ muss man nicht mehr aus verstreuten Logzeilen rekonstruieren, was vermutlich passiert ist. Man sieht den Ablauf.
Ein Detail, auf das wir Wert gelegt haben: Das System füllt keine Lücken auf. Wenn ein Teil der Ausführungshistorie fehlt, wird das angezeigt — und nicht durch eine plausibel aussehende Rekonstruktion ersetzt. Ein Nachweis, der an den unsicheren Stellen rät, ist schlimmer als gar keiner, weil man ihm glaubt.
Lückenlosigkeit, die sich prüfen lässt
Ein Agent läuft in einem eigenen Container, oft beim Kunden, und meldet seine Ereignisse an die Plattform. Daraus ergibt sich eine unangenehme Frage: Woher weiß man, dass dabei nichts verloren ging — oder nachträglich verändert wurde?
Jedes Ereignis trägt deshalb eine fortlaufende Sequenznummer und einen Hash, der den Vorgänger einschließt. Beim Eingang prüft die Plattform beides: Passt die Nummer lückenlos an die vorige an, und passt der Hash zur bisherigen Kette? Wenn nicht, wird der Zustand als broken markiert — samt Begründung.
Das ist bewusst strenger als Monitoring. Monitoring sagt Ihnen, ob ein System läuft. Eine geprüfte Ereigniskette sagt Ihnen, ob die Aufzeichnung dessen, was es getan hat, vollständig ist. Bei einem System, das selbstständig in Kundendaten schreibt, ist das der Unterschied zwischen einem Protokoll und einem Nachweis.
Wenn etwas auffällt, bevor jemand fragt
Aus denselben Daten entstehen Alarme. Vier Typen decken in der Praxis das meiste ab:
Agent offline — der Agent meldet sich nicht mehr. Bei einem System, das im Hintergrund arbeiten soll, fällt das sonst erst auf, wenn ein Ergebnis ausbleibt.
Häufung abgelehnter Aktionen — der Agent versucht wiederholt etwas, wofür ihm die Rechte fehlen. Entweder ist seine Aufgabe falsch zugeschnitten, oder er läuft in eine Richtung, die so nicht gedacht war.
Häufung von Fehlern — die Fehlerrate steigt gegenüber dem Normalbetrieb.
Kette unterbrochen — die Integritätsprüfung schlägt an.
Jeder Alarm hat eine Schwere von niedrig bis kritisch und geht wahlweise in die Oberfläche, per E-Mail oder an einen Webhook. Der Punkt ist nicht die Benachrichtigung an sich, sondern dass die Auffälligkeit aus dem Verhalten des Agenten abgeleitet wird und nicht aus der Systemauslastung.
Im Video zu sehen
Wie das in der Oberfläche aussieht, zeigen wir in diesem kurzen Video — Dashboard, Turn-Suche und die Detailansicht eines einzelnen Ablaufs:
Warum das keine Nebensache ist
Es gibt einen betrieblichen Grund und einen regulatorischen.
Betrieblich: Ein Agent, dessen Verhalten man nicht nachvollziehen kann, lässt sich nicht verbessern. Man kann ihn abschalten oder ihm weiter vertrauen, aber man kann nicht gezielt an der Stelle nachbessern, an der er danebenlag — weil man diese Stelle nicht kennt.
Regulatorisch: Der AI Act verlangt für Systeme mit entsprechendem Risiko Protokollierung und menschliche Aufsicht. „Wir haben den Chatverlauf“ ist dafür keine tragfähige Antwort. Eine lückenlos geprüfte Aufzeichnung dessen, welche Werkzeuge mit welchen Daten aufgerufen wurden, schon eher.
Unsere Haltung dabei ist unbequem, aber wir halten sie für richtig: Wer Agenten einsetzt, die eigenständig handeln, übernimmt Verantwortung für dieses Handeln. Observability ist das Werkzeug, mit dem diese Verantwortung überhaupt wahrnehmbar wird. Ohne sie bleibt nur Vertrauen — und Vertrauen ohne Nachprüfbarkeit ist bei autonomen Systemen keine gute Grundlage.
Agent Observability ist Teil der HybridAI-Plattform und für gehostete HybridClaw-Agenten verfügbar.
Häufige Fragen
Was ist ein Turn?
Die Abfolge, mit der ein Agent auf eine Eingabe reagiert: Er wählt Werkzeuge, ruft sie auf, bewertet die Ergebnisse und formuliert eine Antwort. Ein aufgezeichneter Turn lässt sich aufklappen wie ein Protokoll.
Woran erkenne ich, dass Ereignisse fehlen oder verändert wurden?
Jedes Ereignis trägt eine fortlaufende Sequenznummer und einen Hash, der den Vorgänger einschließt. Passt eins nicht, wird die Kette als „broken“ markiert – samt Begründung.
Welche Alarme gibt es?
Agent offline, Häufung abgelehnter Aktionen, Häufung von Fehlern und unterbrochene Kette, jeweils mit Schwere von niedrig bis kritisch – in der Oberfläche, per E-Mail oder an einen Webhook.
Für welche Agenten gilt das?
Agent-Observability ist Teil der hybridAI-Plattform und für gehostete HybridClaw-Agenten verfügbar.
Kurz gesagt: CRM-Daten sind lückenhaft, weil der Außendienst nach einem Termin keine Formulare ausfüllt, nicht weil es an Auswertung fehlt. Die Lösung ist Eingabe per Stimme direkt nach dem Gespräch. Der Sales Companion von hybridAI ist eine iPhone-App mit CarPlay, die als Sprachschnittstelle auf dem bestehenden CRM sitzt – Salesforce, SAP, Dynamics oder Zoho. Aus einem gesprochenen Absatz werden Besuchsbericht, Angebotsentwurf und Deal-Einschätzung.
Aufgabe
Heute im CRM
Mit dem Sales Companion
Besuchsbericht
abends elf Formularfelder
auf dem Parkplatz diktiert, Felder automatisch befüllt
Angebot
Mengen und Preise abtippen
gesprochen → Entwurf, exakt berechnet vom Code, nicht vom Sprachmodell
Briefing vor dem Termin
CRM am Schreibtisch durchsuchen
auf der Fahrt per Frage: offene Angebote, letzte Bestellungen, Notizen, E-Mails
Auswertung
auf den BI-Report warten
in Sekunden per Frage (Text-to-SQL)
Daten
neues System, Migration
bleiben im bestehenden CRM
Jedes Unternehmen, das ein CRM betreibt, kennt die gleiche Klage aus dem Vertrieb: „Das System kostet mich mehr Zeit, als es mir bringt.“ Die üblichen Antworten darauf sind Schulungen, Pflichtfelder, Reminder-Mails und irgendwann Druck vom Management. Sie funktionieren selten, und der Grund dafür ist strukturell.
Warum CRM-Daten unvollständig sind
Ein Außendienstmitarbeiter führt ein vierzig Minuten langes Gespräch beim Kunden. Darin stecken: eine Mengenangabe, ein Preisvorbehalt, die Information, dass der eigentliche Entscheider gerade gewechselt hat, eine Beschwerde über die letzte Lieferung, und ein Gefühl dafür, wie wahrscheinlich der Abschluss ist.
Was davon im CRM landet, hängt daran, ob diese Person zwei Stunden später — nach zwei weiteren Terminen, im Zug oder abends zu Hause — die Energie aufbringt, elf Formularfelder auszufüllen. Meistens landet ein Satz darin. Manchmal gar nichts.
Das ist kein Disziplinproblem. Es ist ein Schnittstellenproblem. Das Gespräch ist gesprochene Sprache, unstrukturiert, voller Kontext. Das CRM erwartet Formularfelder. Dazwischen liegt eine Übersetzungsleistung, die jemand manuell erbringen muss — und zwar ausgerechnet die Person, deren Zeit am teuersten ist.
Die gesamte KI-Diskussion der letzten Jahre hat sich auf die andere Richtung konzentriert: bessere Auswertung der Daten, die schon da sind. Dashboards, Forecasts, Lead Scoring. Das ist nicht falsch, aber es behandelt das Symptom. Wenn die Hälfte dessen, was im Markt passiert, nie ins System gelangt, ist auch das beste Modell darauf eine Analyse von Lücken.
Warum Realtime Voice hier anders ist als Chat
Sprachsteuerung für Software gibt es seit zwanzig Jahren, und sie war fast immer enttäuschend. Der Unterschied heute liegt nicht in der Spracherkennung — die war auch vorher schon brauchbar — sondern darin, was zwischen Erkennung und Ausführung passiert.
Ein Realtime-Voice-Modell hört nicht zu und tippt mit. Es versteht einen gesprochenen Absatz, erkennt darin verschiedene Sachverhalte, ordnet sie unterschiedlichen Zielstrukturen zu und fragt nach, wenn etwas fehlt. Aus
„Gerade bei Müller GmbH raus. Die wollen 200 Stück zum Q3-Preis, Entscheidung bis Monatsende — ich würde auf 70 Prozent gehen.“
werden drei verschiedene Einträge: ein Besuchsbericht, ein Angebotsentwurf und eine Deal-Einschätzung. Jeder landet dort, wo er hingehört, mit den richtigen Feldern befüllt.
Entscheidend ist der Zeitpunkt. Das funktioniert auf dem Parkplatz, zwei Minuten nach dem Termin, während die Details noch präsent sind. Nicht abends, wenn die Erinnerung schon abgeschliffen ist und die Motivation fehlt.
Der zweite Unterschied zu Chat ist die Freihändigkeit. Ein Vertriebler im Auto kann nicht tippen, aber er kann sprechen. Genau in diesem Zeitfenster — zwischen zwei Terminen — ist er am ehesten bereit, etwas zu erledigen, was sonst liegen bleibt.
Lesen und Schreiben gehören zusammen
Eine reine Diktierfunktion wäre nur die halbe Lösung. Interessant wird es, wenn dieselbe Stimme auch Auskunft gibt.
„Was muss ich über diesen Kunden wissen?“ auf der Fahrt zum Termin — und die Antwort enthält offene Angebote, die letzten Bestellungen, Notizen vom vorherigen Besuch und die relevanten E-Mails der letzten Wochen. Das ist dieselbe Datenbasis, die auch am Schreibtisch zur Verfügung steht, nur über eine Schnittstelle, die im Auto funktioniert.
Technisch sind das zwei verschiedene Aufgaben. Fragen nach Umsätzen, Mengen und Pipeline müssen zu exakten Abfragen auf strukturierte Daten werden — da darf nichts geschätzt werden, Zahlen sind Zahlen. Fragen nach Hintergründen, Gesprächsverläufen oder Produktdetails müssen dagegen semantisch über unstrukturierte Dokumente laufen: Protokolle, E-Mails, Datenblätter, Verträge.
Wir trennen das bewusst in zwei Pfade — Text-to-SQL für die Zahlen, semantische Suche für die Geschichte dahinter — und lassen ein drittes Modell die Ergebnisse zusammenführen und erklären. Die Arithmetik macht dabei nie das Sprachmodell, sondern der Code. Ein Angebot, dessen Summe ein LLM „geschätzt“ hat, wäre unbrauchbar.
Was das in der Praxis bedeutet: Sales Companion
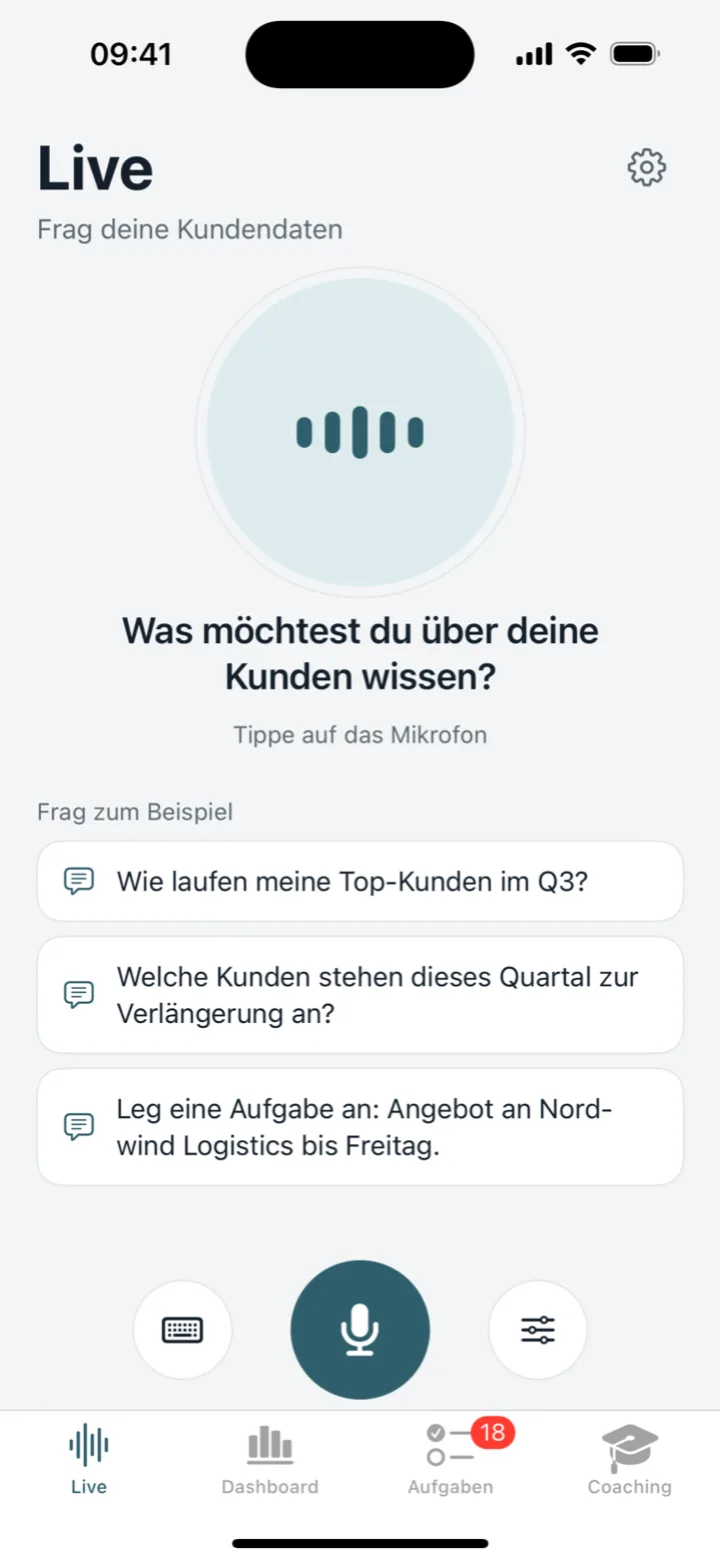
Genau dafür haben wir den Sales Companion gebaut: eine iPhone-App mit CarPlay-Unterstützung, die als Sprachschnittstelle auf dem bestehenden CRM sitzt.
Die Sprachansicht des Sales Companion: eine Frage stellen, statt ein Formular zu suchen.
Wichtig dabei: Es ist kein neues CRM. Die Daten bleiben in Salesforce, SAP, Dynamics oder Zoho, wo sie heute schon liegen. Es kommt eine Schicht darüber, die über Adapter auf diese Systeme zugreift. Keine Migration, kein Parallelsystem, keine Umgewöhnung für die Teams, die am Schreibtisch weiter mit ihrem gewohnten Werkzeug arbeiten.
Im Alltag sieht das so aus:
Briefing vor dem Termin — die relevanten Informationen zum Kunden, zusammengefasst auf der Anfahrt.
Besuchsbericht danach — diktiert statt getippt, mit Kunde, Ansprechpartnern, Themen und nächsten Schritten.
Angebotsentwurf — gesprochene Mengen und Preise werden zu einem Entwurf, exakt gerechnet.
Analysen auf Zuruf — „Welche Kunden haben dieses Quartal weniger bestellt als letztes?“ in Sekunden, ohne auf einen BI-Report zu warten.
Ein Teil, der uns selbst überrascht hat, wie gut er ankommt: Dieselbe Stimme, die die Kunden kennt, taugt auch zum Üben. Ein Rollenspiel mit einer KI, die den Gesprächspartner spielt, Einwände bringt und Widerstand leistet — danach eine Auswertung pro Fähigkeit und konkrete Hinweise, woran zu arbeiten ist. Für neue Mitarbeiter im Vertrieb ist das deutlich wirksamer als jedes Handbuch.
Datenschutz ist keine Fußnote
Wer Kundengespräche durch ein Sprachmodell schickt, muss wissen, wohin die Daten gehen. Unsere Infrastruktur läuft auf europäischen Servern, DSGVO- und AI-Act-konform. Personenbezogene Daten lassen sich maskieren, bevor ein Prompt ein Modell erreicht, und über Rollen steuern Sie, welche Teams welche Datenquellen überhaupt erreichen.
Das ist kein nachgereichtes Feature, sondern bei einem System, das Besuchsberichte über reale Ansprechpartner erfasst, eine Voraussetzung dafür, dass es überhaupt eingesetzt werden darf.
Häufige Fragen
Ist der Sales Companion ein neues CRM?
Nein. Die Daten bleiben in Salesforce, SAP, Dynamics oder Zoho; der Sales Companion sitzt über Adapter darauf. Keine Migration, kein Parallelsystem.
Rechnet die KI die Angebotssummen?
Nein. Zahlen kommen über exakte Abfragen auf die strukturierten Daten, die Arithmetik macht der Code. Ein geschätztes Angebot wäre unbrauchbar.
Wo liegen die Daten?
Auf europäischen Servern, DSGVO- und AI-Act-konform. Personenbezogene Daten lassen sich vor dem Modellaufruf maskieren, Rollen steuern den Zugriff.
Kann ich es ausprobieren?
Ja, auf unserer Agentic-CRM-Seite: Demo-Videos und die Sprachschnittstelle auf Beispieldaten, ohne Anmeldung.
Ausprobieren
Auf unserer Seite zum Agentic CRM können Sie sich die Demo-Videos ansehen und die Sprachfunktion direkt testen — die öffentliche Demo läuft auf Beispiel-Vertriebsdaten, ohne Anmeldung.
Die interessantere Frage ist ohnehin nicht, ob die Technik funktioniert. Sie ist, ob Ihr Vertrieb sie benutzt. Unsere Erfahrung bisher: Wenn die Eingabe zwei Minuten auf dem Parkplatz dauert statt zwanzig Minuten am Abend, benutzen sie sie.
Manage Consent
To provide the best experiences, we use technologies like cookies to store and/or access device information. Consenting to these technologies will allow us to process data such as browsing behavior or unique IDs on this site. Not consenting or withdrawing consent, may adversely affect certain features and functions.
Functional
Immer aktiv
The technical storage or access is strictly necessary for the legitimate purpose of enabling the use of a specific service explicitly requested by the subscriber or user, or for the sole purpose of carrying out the transmission of a communication over an electronic communications network.
Preferences
The technical storage or access is necessary for the legitimate purpose of storing preferences that are not requested by the subscriber or user.
Statistics
The technical storage or access that is used exclusively for statistical purposes.The technical storage or access that is used exclusively for anonymous statistical purposes. Without a subpoena, voluntary compliance on the part of your Internet Service Provider, or additional records from a third party, information stored or retrieved for this purpose alone cannot usually be used to identify you.
Marketing
The technical storage or access is required to create user profiles to send advertising, or to track the user on a website or across several websites for similar marketing purposes.