Ein Chatbot, der eine falsche Antwort gibt, ist ein Ärgernis. Ein Agent, der eigenständig eine E-Mail verschickt, einen Datensatz ändert oder ein Angebot erstellt, ist etwas anderes. Er handelt — und wer handelt, muss sich erklären können.
Die meisten Teams, die heute Agenten in Betrieb nehmen, merken das erst beim ersten Zwischenfall. Dann steht die Frage im Raum: Was genau ist da passiert? Und die ehrliche Antwort lautet überraschend oft: Wir wissen es nicht mehr.
Warum Logs für Agenten nicht reichen
Klassisches Logging ist für Software gemacht, die Anweisungen abarbeitet. Eine Zeile pro Ereignis, Zeitstempel, Schweregrad. Für einen Webserver ist das angemessen.
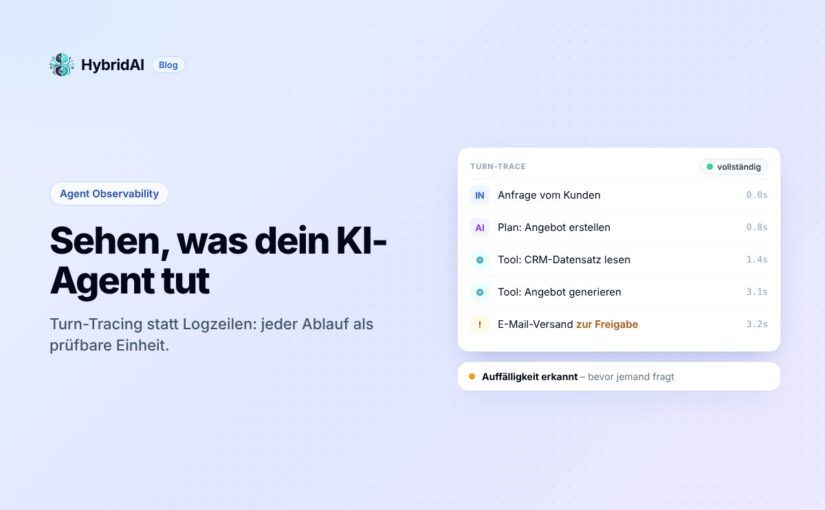
Ein Agent arbeitet anders. Auf eine Eingabe hin entscheidet er selbst, welche Werkzeuge er benutzt, ruft eins davon auf, bewertet das Ergebnis, ruft womöglich das nächste auf und formuliert am Ende eine Antwort. Diese Abfolge nennen wir einen Turn. Was dabei zählt, ist nicht das einzelne Ereignis, sondern der Zusammenhang: Welches Modell war beteiligt? Welche Werkzeuge wurden mit welchen Argumenten aufgerufen? Was kam zurück? Und an welcher Stelle wurde die Entscheidung getroffen, die am Ende zum Problem wurde?
Ein Chatverlauf zeigt davon nur die Oberfläche: Frage rein, Antwort raus. Alles dazwischen — und genau dort passiert das Handeln — bleibt unsichtbar.
Turn-Tracing: der Ablauf als Einheit
Wir haben Observability deshalb um den Turn herum gebaut und nicht um die einzelne Logzeile. Ein aufgezeichneter Turn lässt sich aufklappen wie ein Protokoll: jeder Werkzeugaufruf mit seinen Argumenten, jedes Ergebnis, jeder Modellaufruf, in der Reihenfolge, in der es tatsächlich geschah.
Das macht einen praktischen Unterschied. Bei der Frage „Warum hat der Agent diesen Kunden angeschrieben?“ muss man nicht mehr aus verstreuten Logzeilen rekonstruieren, was vermutlich passiert ist. Man sieht den Ablauf.
Ein Detail, auf das wir Wert gelegt haben: Das System füllt keine Lücken auf. Wenn ein Teil der Ausführungshistorie fehlt, wird das angezeigt — und nicht durch eine plausibel aussehende Rekonstruktion ersetzt. Ein Nachweis, der an den unsicheren Stellen rät, ist schlimmer als gar keiner, weil man ihm glaubt.
Lückenlosigkeit, die sich prüfen lässt
Ein Agent läuft in einem eigenen Container, oft beim Kunden, und meldet seine Ereignisse an die Plattform. Daraus ergibt sich eine unangenehme Frage: Woher weiß man, dass dabei nichts verloren ging — oder nachträglich verändert wurde?
Jedes Ereignis trägt deshalb eine fortlaufende Sequenznummer und einen Hash, der den Vorgänger einschließt. Beim Eingang prüft die Plattform beides: Passt die Nummer lückenlos an die vorige an, und passt der Hash zur bisherigen Kette? Wenn nicht, wird der Zustand als broken markiert — samt Begründung.
Das ist bewusst strenger als Monitoring. Monitoring sagt Ihnen, ob ein System läuft. Eine geprüfte Ereigniskette sagt Ihnen, ob die Aufzeichnung dessen, was es getan hat, vollständig ist. Bei einem System, das selbstständig in Kundendaten schreibt, ist das der Unterschied zwischen einem Protokoll und einem Nachweis.
Wenn etwas auffällt, bevor jemand fragt
Aus denselben Daten entstehen Alarme. Vier Typen decken in der Praxis das meiste ab:
- Agent offline — der Agent meldet sich nicht mehr. Bei einem System, das im Hintergrund arbeiten soll, fällt das sonst erst auf, wenn ein Ergebnis ausbleibt.
- Häufung abgelehnter Aktionen — der Agent versucht wiederholt etwas, wofür ihm die Rechte fehlen. Entweder ist seine Aufgabe falsch zugeschnitten, oder er läuft in eine Richtung, die so nicht gedacht war.
- Häufung von Fehlern — die Fehlerrate steigt gegenüber dem Normalbetrieb.
- Kette unterbrochen — die Integritätsprüfung schlägt an.
Jeder Alarm hat eine Schwere von niedrig bis kritisch und geht wahlweise in die Oberfläche, per E-Mail oder an einen Webhook. Der Punkt ist nicht die Benachrichtigung an sich, sondern dass die Auffälligkeit aus dem Verhalten des Agenten abgeleitet wird und nicht aus der Systemauslastung.
Im Video zu sehen
Wie das in der Oberfläche aussieht, zeigen wir in diesem kurzen Video — Dashboard, Turn-Suche und die Detailansicht eines einzelnen Ablaufs:
Warum das keine Nebensache ist
Es gibt einen betrieblichen Grund und einen regulatorischen.
Betrieblich: Ein Agent, dessen Verhalten man nicht nachvollziehen kann, lässt sich nicht verbessern. Man kann ihn abschalten oder ihm weiter vertrauen, aber man kann nicht gezielt an der Stelle nachbessern, an der er danebenlag — weil man diese Stelle nicht kennt.
Regulatorisch: Der AI Act verlangt für Systeme mit entsprechendem Risiko Protokollierung und menschliche Aufsicht. „Wir haben den Chatverlauf“ ist dafür keine tragfähige Antwort. Eine lückenlos geprüfte Aufzeichnung dessen, welche Werkzeuge mit welchen Daten aufgerufen wurden, schon eher.
Unsere Haltung dabei ist unbequem, aber wir halten sie für richtig: Wer Agenten einsetzt, die eigenständig handeln, übernimmt Verantwortung für dieses Handeln. Observability ist das Werkzeug, mit dem diese Verantwortung überhaupt wahrnehmbar wird. Ohne sie bleibt nur Vertrauen — und Vertrauen ohne Nachprüfbarkeit ist bei autonomen Systemen keine gute Grundlage.
Agent Observability ist Teil der HybridAI-Plattform und für gehostete HybridClaw-Agenten verfügbar.